
🎙️
任意音色
用你自己的 RVC 模型换音色,别人的 AI 是文字,你的 AI 开口说话。
这是最常被问到的问题,先给结论:
| 项目 | 最低 | 推荐 | 说明 |
|---|---|---|---|
| 显卡显存 | 2 GB | 4 GB 以上 | 见 显存详解 |
| 显卡架构 | NVIDIA,计算能力 ≥ 6.0 | — | P106-100 / P106-090 / P4 / P40 / GTX 10 系 / RTX 全系都可以 |
| 驱动 | ≥ 525(支持 CUDA 12.1) | — | nvidia-smi 能输出即可 |
| CPU / 内存 | 双核 / 4 GB | 4 核 / 8 GB | 显存小的机器建议配 4 GB swap |
| 磁盘 | 8 GB 可用 | 15 GB | PyTorch + CUDA 运行库约占 6 GB |
| 系统 | Ubuntu 20.04+ / Windows 10+ | Ubuntu 22.04 | 也支持 Docker、Colab、安卓 |
没有显卡也能跑
把 rvc.device 设成 "cpu",或者让 rvc.min_vram_mb 高于你的显存,服务会自动用 CPU。 速度大约是实时的 3~5 倍耗时。只想快速验证链路的话,把 rvc.enabled 设成 false 更省事。
跑在有显卡的机器上,对外提供 HTTP 合成接口。Edge TTS 生成基础语音,再用 RVC 换成目标音色,输出 wav。
跑在 AstrBot 里,拦截 AI 的文本回复、过滤括号里的动作描写,再调用服务端把文字换成语音消息。
两部分完全独立,通过 HTTP 通信,可以装在同一台机器,也可以分开部署。
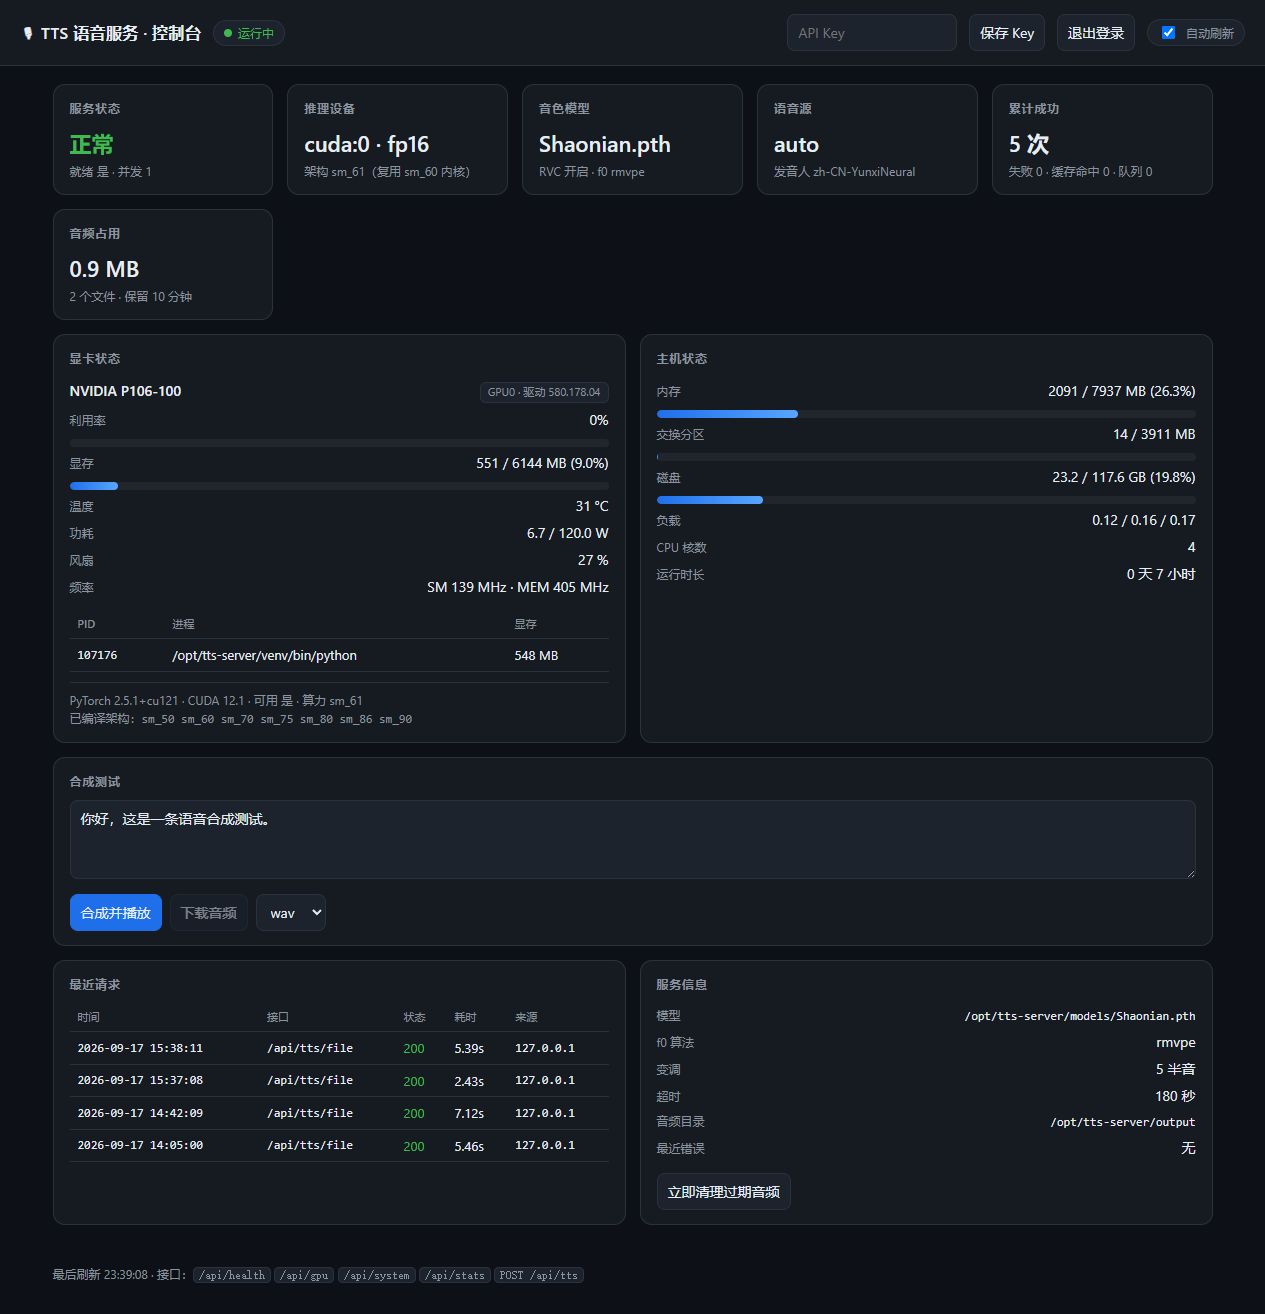
服务端自带一个零依赖的网页控制台(根路径 /),能看到显卡状态、主机状态、在线试听和最近请求, 并且支持密码登录。下图是在 Ubuntu 22.04 + P106-100 上的真实运行截图:
| 环境 | 短句延迟 | 实时倍率 RTF | 显存峰值 |
|---|---|---|---|
| Ubuntu 22.04 + P106-100 6 GB | 2 ~ 3 秒 | 0.41x | 0.9 ~ 2 GB |
| Windows + Tesla P4 8 GB | 4 ~ 6 秒 | 0.70 ~ 0.89x | — |
| 纯 CPU(4 核) | 15 ~ 40 秒 | 3 ~ 5x | — |
RTF(实时倍率)= 处理耗时 ÷ 音频时长,越小越快,小于 1 表示比实时快。