
安卓手机部署
同一套服务端代码可以跑在安卓手机上(需要 root),把手机当成一台随身语音服务器。
原理
用 proot / chroot 在手机上跑一个 Ubuntu arm64 环境,里面装自带 Python 运行时和依赖, 通过一个配置 App 管理启停。
步骤
bash
# 1. 推脚本到手机
git clone https://github.com/yake1145141/voice-tts-system.git
# 国内网络慢的话,改用加速地址:
# git clone https://gh-proxy.cn/https://github.com/yake1145141/voice-tts-system.git
cd voice-tts-system
adb push deploy/android/1_setup_rootfs.sh /data/local/tmp/

# 2. 在手机上建 chroot 环境
adb shell su -c "sh /data/local/tmp/1_setup_rootfs.sh"

# 3. 推送代码 / 模型 / 权重后安装依赖
adb push tts-server /data/local/tmp/
adb push models/MyVoice.pth /data/local/tmp/models/
adb shell su -c "sh /data/local/tmp/2_install_server.sh"

# 4. 装配置 App
adb install -r android-app/dist/tts-server-config.apk
详细说明见仓库里的 deploy/android/README.md。
配置 App 能做什么
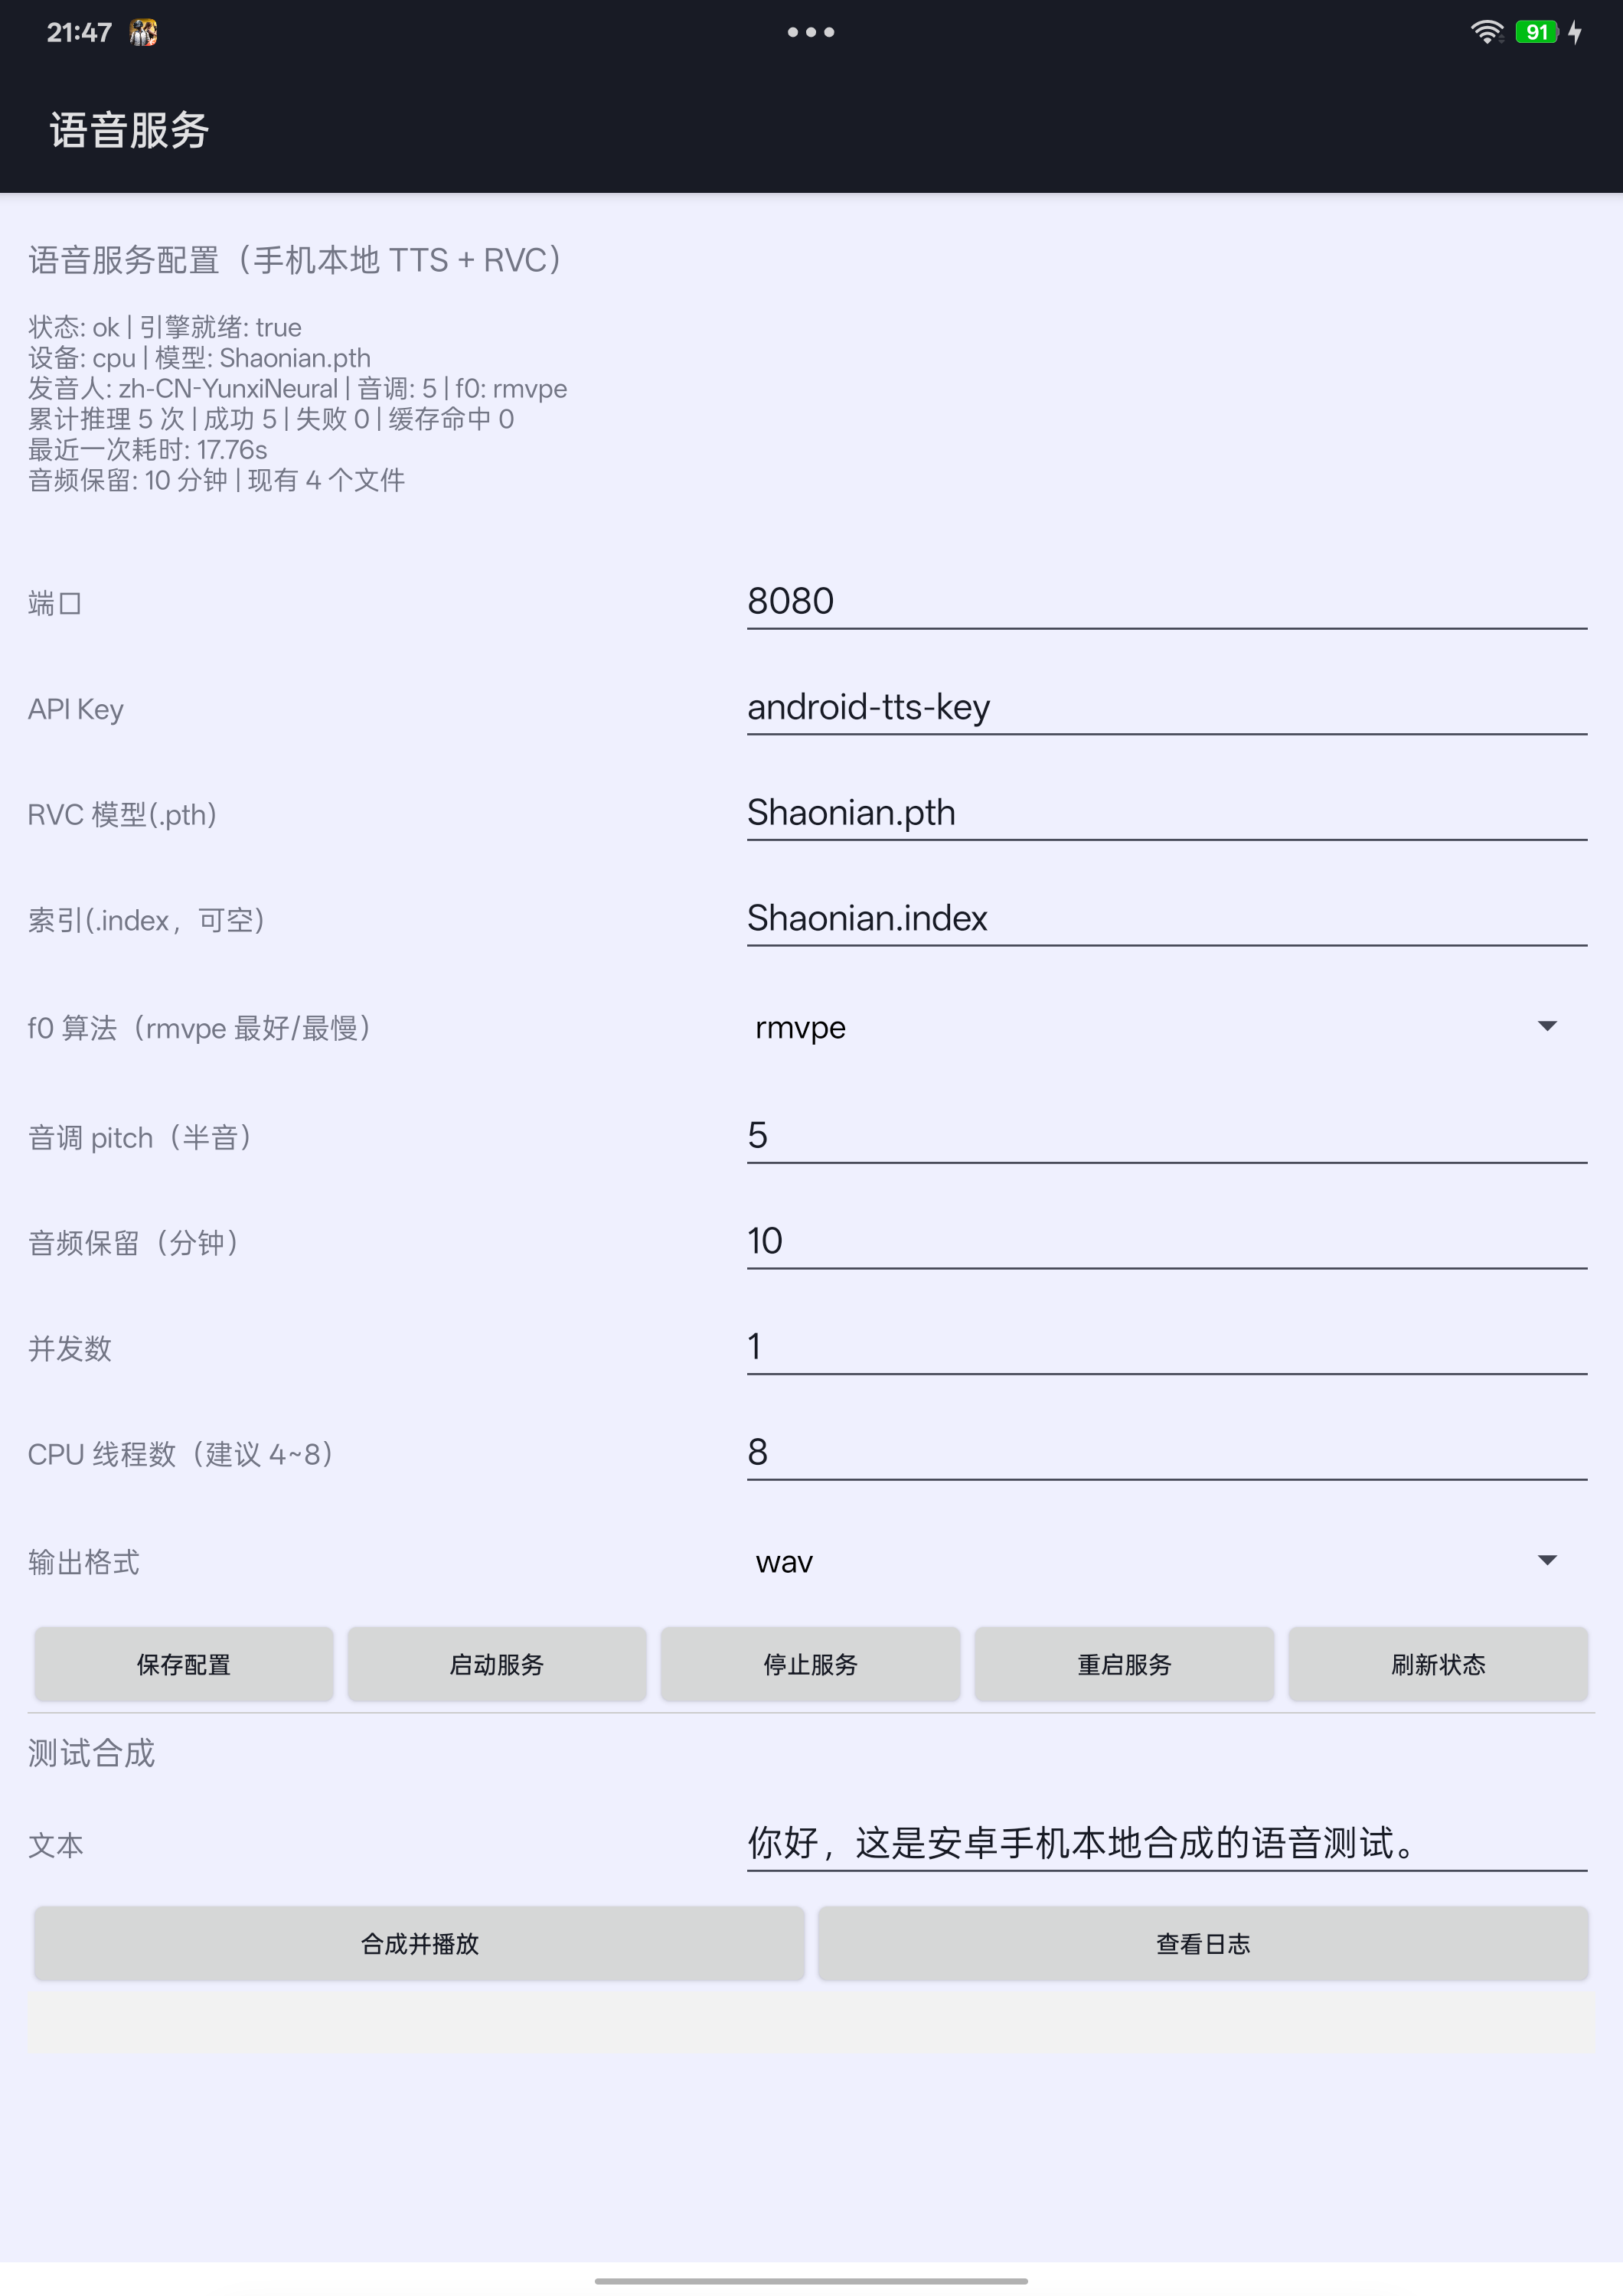
- 改端口 / API Key / 模型名 / f0 算法 / 音调 / 音频保留时间 / 并发数 / 线程数
- 一键启动、停止、刷新状态
- 直接在手机上试听合成效果
电脑这边用 adb forward tcp:8080 tcp:8080,或者直接用局域网 IP, 就能把 AstrBot 指过去。
实测性能
Snapdragon 8 Gen 3,CPU 推理:4 秒音频约 11.5 秒生成(2.78x 实时), 比桌面 CPU 快,比 GPU 慢约 2.5 倍。
安卓 GPU 目前跑不了 RVC
安卓上没有可用的 PyTorch GPU 后端,只能走 CPU。 要上 GPU 需要改成 ONNX + NNAPI / QNN 重写整条推理链路, 详见仓库里 deploy/android/README.md 第六节。